


作者:边缘侧AI合作伙伴关系总监Yuval Zukerman
2026年9月15日
语音助手、智能耳机和物联网设备都面临相同挑战:设备必须持续监听用户请求,同时又要避免耗尽电池电量。在启动语音识别之前,设备需要一个轻量级“守门人”来判断是否有人正在说话。
而充当“守门人”的正是语音活动检测(VAD)。
在近期被Interspeech 收录的一篇论文中,ADI与加州大学洛杉矶分校(UCLA)的研究人员介绍了一款专为资源受限的边缘设备设计的语音活动检测器,名为kiloVAD。最终模型仅包含2100个参数,在可部署的Causal VAD系统中实现了优异性能,同时保持与嵌入式机器学习工具链的兼容性。
微型VAD模型为何难以构建
云端的GPU服务器能够接入电网并拥有丰富的AI工具集,而耳机等边缘设备只能依赖电池供电的超高能效处理器。边缘设备内存有限,要求模型体量必须小巧,但这仅是基础门槛。成功的边缘端VAD模型还必须满足四项严格约束,而大多数针对此类任务的研究模型往往只能忽略这些约束。
- 模型需利用芯片内置的音频预处理功能。在运行任何AI之前,原始音频信号必须转换为可用格式。非边缘模型通常会计算自定义音频表示形式,此举会增加开销,并破坏与设备其余音频处理流程的兼容性。大多数边缘芯片配备专用硬件来执行此操作,这是一种内置捷径,模型设计人员必须加以适配。
- 模型只能使用芯片支持的数学运算。除预处理外,模型的内部运算还必须在低功耗硬件上高效运行。通用模型通常依赖专用计算,而嵌入式处理器对此类计算的处理能力较差,甚至无法执行。
- 模型必须快速做出决策。大多数模型需要接收超过半秒的音频后,才能判断是否有人说话。对于本应具备即时响应体验的设备而言,这个等待时间会造成明显延迟。
- 模型在实际条件下必须保持准确。在对模型进行基准测试时,实际部署场景的数据集往往不够理想。由于边缘模型对低延迟有严格要求,模型无法利用之后的音频(即在初始音频之后采样的数据)来辅助之前的音频的分类。
以部署为先的架构
团队并未先构建大模型再进行缩减,而是专门为嵌入式推理构建了kiloVAD。
此模型基于常见微控制器的功能构建:采用全卷积神经网络(CNN)架构。避免使用循环层、自定义数字信号处理(DSP)代码及专用激活函数。与循环神经网络(RNN)相比,CNN通常更易于在边缘设备上部署。CNN采用固定计算,能够高效并行运行,并获得嵌入式AI运行时的良好支持。模型还依赖于梅尔频谱图。这是一种固定的、受人类听觉启发的频率表示方法,在嵌入式系统中得到广泛支持。
上述特性使得设计方案在不同硬件平台上具有良好可移植性,并与常见嵌入式机器学习工作流兼容。当需要进行深度压缩时,这种便捷性成为重要优势。
寻找延迟的最佳平衡点
论文的一项关键发现是,随着音频上下文增加,VAD性能会迅速提升,但存在上限。
研究人员评估了60毫秒至360毫秒的输入窗口(即音频样本),发现性能在200毫秒左右基本趋于平稳。为说明这种样本时长有多短,这里科普一下,200毫秒仅够发出一个音节。
在200毫秒窗口下,kiloVAD达到了与更长窗口几乎相同的准确度,同时大幅缩短了响应时间。对于始终开启的系统而言,这一点尤为重要,因为每一毫秒的延迟都会影响用户体验。与几款使用630毫秒上下文的主流紧凑型VAD模型相比,kiloVAD将延迟降低了约三分之二。
团队还研究了不同的梅尔频谱图分辨率,即将音频频率划分到各个梅尔频带中。每个梅尔频带代表一个频率范围,大致对应人类对音调差异的感知。研究表明,减少梅尔频带数量时,准确度会平缓下降。
借助这种灵活性,在DSP能力各异的嵌入式平台上部署模型将变得更加容易。
压缩而不损失准确度
然而,此项工作最令人印象深刻之处在于模型的压缩程度。
完整版kiloVAD模型约包含 81000个参数。团队致力于对模型进行剪枝,即通过移除未充分利用和重复的元素来减小神经网络规模,同时尽量减少对模型性能的影响。研究人员采用逐层优化的结构化剪枝策略,将原始模型参数减少至仅2100个,缩减幅度达 97.4% 。
团队并未对所有层采用相同的剪枝率,而是为每一层单独寻找最佳剪枝比例。随后,团队通过自蒸馏技术恢复了损失的准确度,即由原始模型指导压缩版本的学习。
结果十分显著。即使经过大规模压缩,2.1K参数模型在AVA-Speech基准测试中的表现与完整模型相比,差距仍保持在1.3%以内。
超低比特量化的新方法
压缩仅是解决方案的一半。边缘设备还受益于量化技术。量化技术用低精度整数运算(INT)替代浮点运算,从而减少内存占用。
在INT8(8位整数)部署中,kiloVAD几乎未出现准确度损失。但研究人员希望进一步突破极限。
团队的解决方案是角度感知自蒸馏量化感知训练(QAT)方法。这项技术不仅关注预测准确度,还保留了学习特征与类别表示之间的几何关系。
kiloVAD有何不同?
团队认为,仅凭参数数量无法决定部署的难易程度。模型还必须满足以下四项实际要求:
- 与标准音频前端兼容,即音频处理流程能将麦克风信号转换为AI模型可用的信号
- 支持嵌入式运行时的可移植运算,即完全依赖众多嵌入式处理器提供的数学运算,使模型更易于广泛应用
- 低延迟,即响应速度快
- 严格的因果评估,即模型在实际条件下表现良好,仅使用当前可用音频,而不使用未来音频
在作者进行的行业对比中,kiloVAD是唯一能同时满足上述四项条件并提供优异性能的模型。完整模型的AUC(曲线下面积,一种常见的模型精度指标)达到0.862 AUC,而经剪枝的2.1K参数版本仅使用200毫秒上下文便达到0.850 AUC。
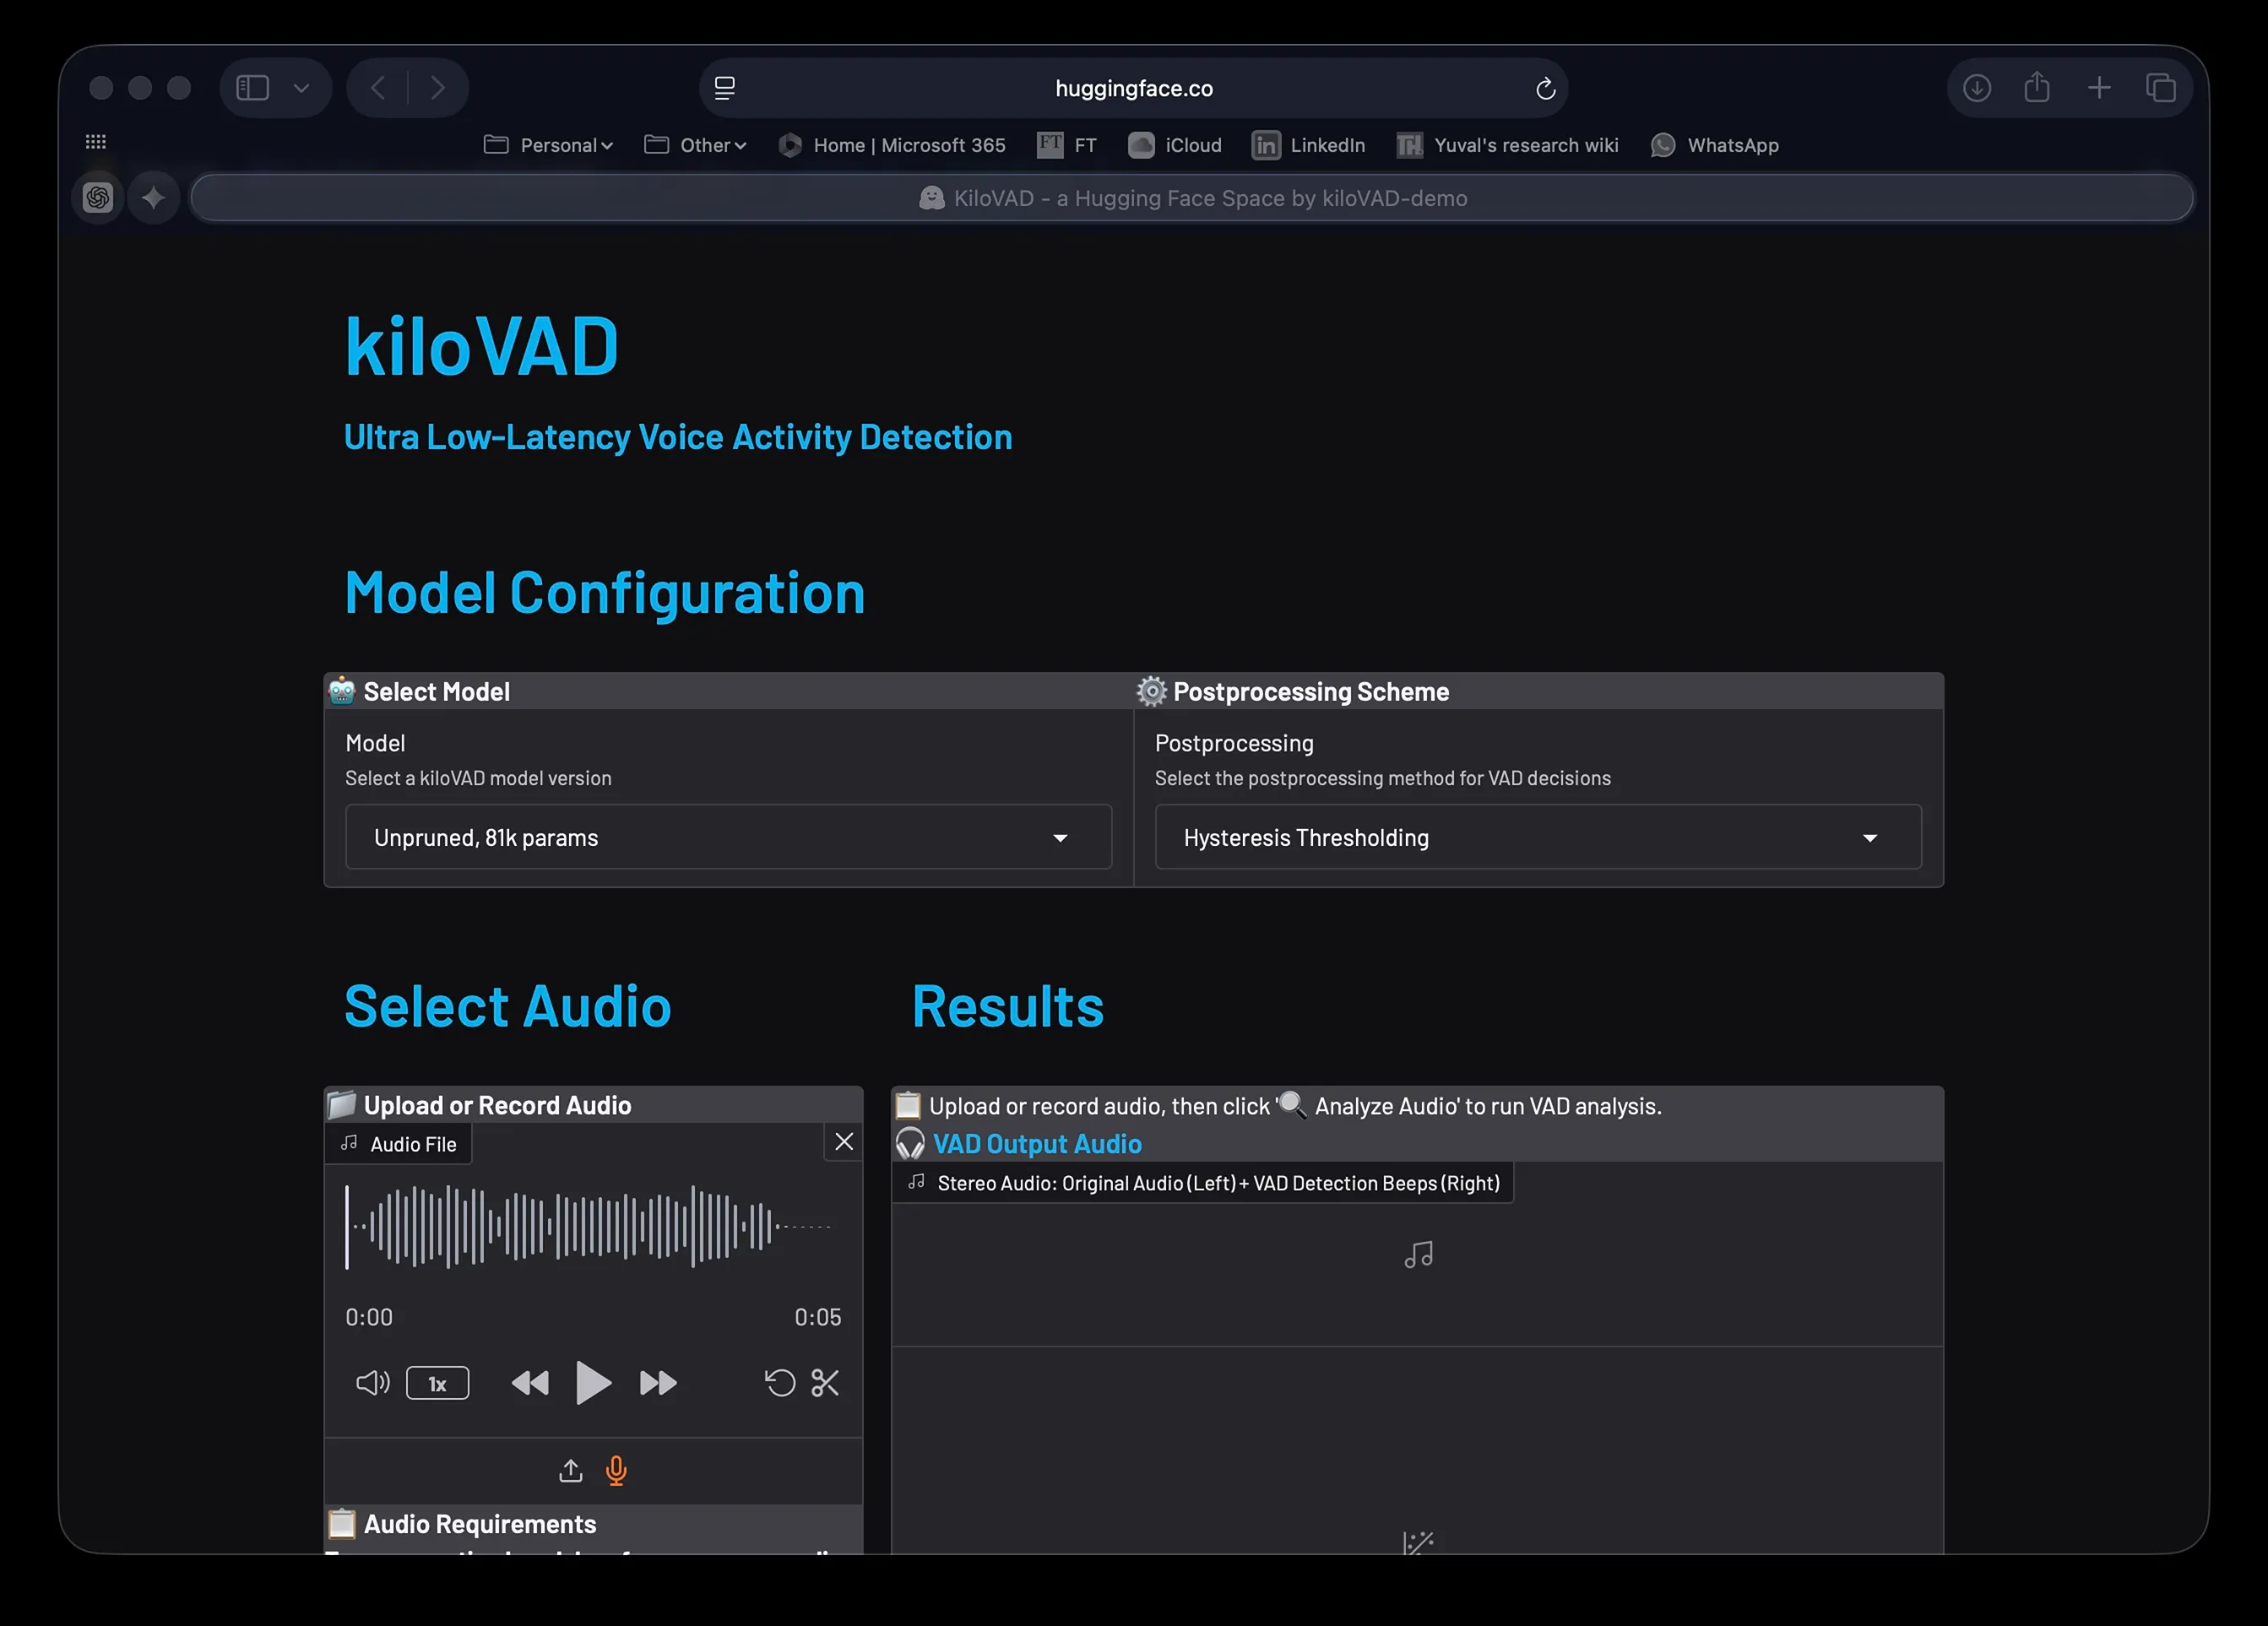
亲自体验!
|
重要意义
许多AI模型只有在受到部署限制的约束而被迫妥协后,才会缩小体量,而kiloVAD选择了不同路径。从特征提取到剪枝和量化,每一项架构决策都以嵌入式部署为核心考量。团队的方法推进了ADI的物理智能愿景,旨在将AI推向现实世界感知与决策发生的最前沿。
最终得到的VAD规模小、速度快、具备因果性且实用性强。
对于构建始终开启的音频系统的工程师而言,上述组合可能比其他参数更多、处理流程更复杂、跑分更高的模型更具价值。kiloVAD的结果证明,通过协同设计硬件、AI架构、压缩和量化,可以将语音检测参数缩减至仅数千个,同时不牺牲实际可用性。