從敲擊到洞察:基於AutoML和Zephyr®的TinyML熟度檢測系統

從敲擊到洞察:基於AutoML和Zephyr®的TinyML熟度檢測系統
作者:ADI 產品應用工程師 Zhiheng Li、 資深軟體系統設計工程師 Tong Zhang、資深軟體工程經理 Chenhui Xu及經理 Nandin Xu
摘要
本文提出了一種因應熟度檢測的高效邊緣AI解決方案。該解決方案將訊號處理(SP)特徵擷取流水線與AutoML訓練的卷積神經網路(CNN)相互結合,實現即時、高精度的分類識別。藉由ADI的一次性(OFA)訓練流水線,系統可自動搜尋最高效的CNN,無需依賴人工反覆偵錯式網路設計。此一優勢在高度量化的TinyML部署場景中尤為重要。該解決方案基於Zephyr OS 4.1建構,提供模組化、可移植的嵌入式軟體基礎,能夠簡化系統整合並加速開發落地。AutoML與Zephyr的結合,大幅降低機器學習和嵌入式工程開發的專業技術門檻,協助客戶更高效地採用邊緣AI微控制器單元(MCU)。此外,由於神經網路天然具備模態無關特性,這套SP + TinyML流水線可輕鬆遷移至音訊、視覺及各類感測器領域的其他邊緣推理任務。
引言
透過敲擊榴槤(一種熱帶水果)並聽音判斷成熟度,本質是分析敲擊過程中產生的振動訊號特徵。該方法可間接評估榴槤內部果肉硬度、密度和含水率等物理狀態;其核心原理是,不同成熟度的榴槤因內部組織結構差異,呈現出不同的振動響應特性。
透過分析振動響應的時頻特徵,系統可在不切開榴槤的情況下判定榴槤成熟度,進而避免果品損耗,並提供即時分析結果,因此適用於大規模分揀場景。該技術已日益廣泛地應用於農業分選和生鮮零售領域,是農產品品質聲學無損檢測的典型應用。
傳統方案擷取頻譜質心(即頻域訊號能量重心)作為分類的關鍵指標。該方案在受控條件下有效,但頻譜質心極易受到外部雜訊、敲擊力度與位置以及個體差異(果實大小、果皮厚度和果刺形態等)影響,導致跨批次、跨環境場景下其穩健性常常較差。與之相比,AI方案直接以時頻特徵輸入(短時傅立葉變換(STFT)或梅爾頻譜等)訓練羽量級卷積或序列模型,學習具備區分度、抗雜訊的特徵表達。結合資料增強/域自我調整技術,此類模型的跨場景泛化能力顯著提升。此外,藉由模型量化與神經架構搜尋(NAS),可將輕量化網路部署於邊緣端,在實現低延遲與低功耗運行的同時,滿足生產分揀與零售質檢的高輸送量需求。因此,相較於單一頻譜質心閾值法,AI榴槤成熟度分類方案在實際部署中展現出更優異的穩健性和可擴展性。搭配不確定性估計和線上重新校準功能,該方案可進一步保障現場長期穩定性與可維護性。
系統架構概述
圖1展示了整體系統架構,由三部分構成:音訊轉碼器(MAX9867)、AI微控制器單元(MAX78002)和TFT-LCD顯示模組(ST7789V)。在典型使用場景中,先使用金屬刀具敲擊榴槤,產生振動或聲學訊號;刀具前端整合的麥克風/振動感測器採集回波訊號;類比訊號經MAX9867轉換為數位訊號,並以I2S格式資料流至MAX78002;MCU內部運行訊號處理(SP)演算法,完成特徵擷取和卷積神經網路(CNN)推理;最後,榴槤成熟度的分類結果顯示在TFT-LCD螢幕上。
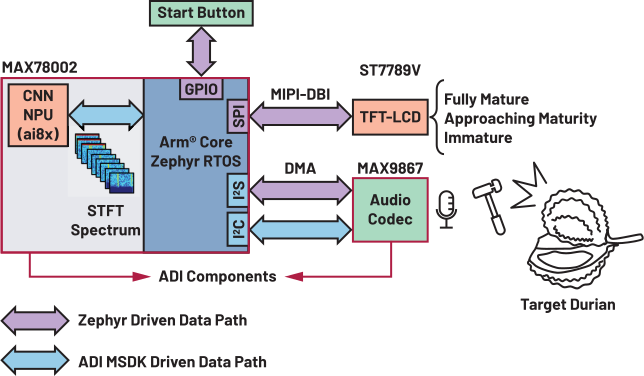
本方案為一套集硬體、AutoML工具和系統級軟體支援於一體的完整解決方案。ai8x工具鏈負責處理模型搜尋和量化,而CodeFusion Studio™ 提供基於 Zephyr的開發環境,以簡化整合並加速部署落地。
資料集與訊號流程
如引言所述,熟度可透過振動頻率響應特性來推斷。因此,本方案採用STFT演算法擷取此特徵,訊號流程如圖2所示。
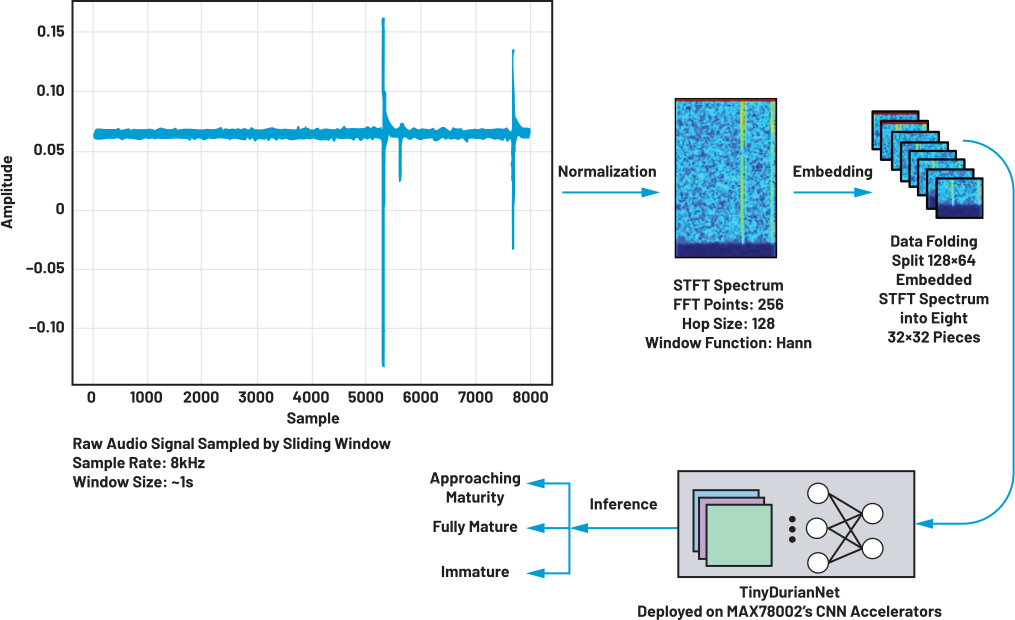
首先,以8kHz取樣速率採集一段一秒長的原始音訊訊號。隨後進行歸一化處理,消除訊號幅值差異。接著,執行STFT變換以獲得訊號幅度頻譜。最後,由於MAX78002的CNN加速器僅支援方形輸入資料,STFT頻譜需經過零填充和維度折疊處理,再輸入TinyDurianNet進行推理。
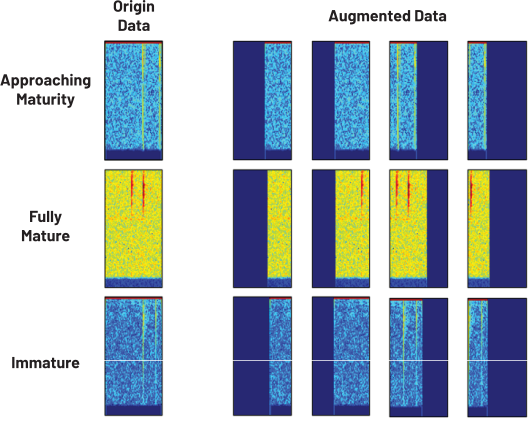
此解決方案將STFT頻譜轉換為RGB圖像來建構資料集。初始資料集包含105個樣本(35個接近成熟、35個完全成熟、35個未成熟)。如圖3所示,透過在視窗內隨機滑動STFT頻譜來類比真實滑動視窗採樣,對資料進行增強。本例中,資料集更新為1155個樣本:20%的樣本用於測試集,80%的樣本用於訓練集。
從超網路到TinyDurianNet——AutoML如何自動反覆運算量化邊緣模型
在邊緣智慧部署中,神經網路模型的設計非常重要。客戶通常選擇ai8x工具提供的示例模型,或自行設計網路架構,然後基於自有資料集進行訓練和推理。然而,訓練結果往往不如人意。原因在於MAX78002使用的量化模型依賴低比特權重(INT8/INT4/INT2),每個權重攜帶的資訊非常有限。因此,相較於傳統FP32模型,量化模型更難穩定收斂,對網路架構設計的要求也更高。因此,採用AutoML搜尋最優模型架構是一種高效解決方案。
ai8x提供了名為一次性(Once-For-All,簡稱OFA)的AutoML訓練流程。OFA的目標是:訓練一個模型(超網路)一次,自動獲得多個性能相當的小型子網路。其訓練流程分為以下三步:
超網路訓練
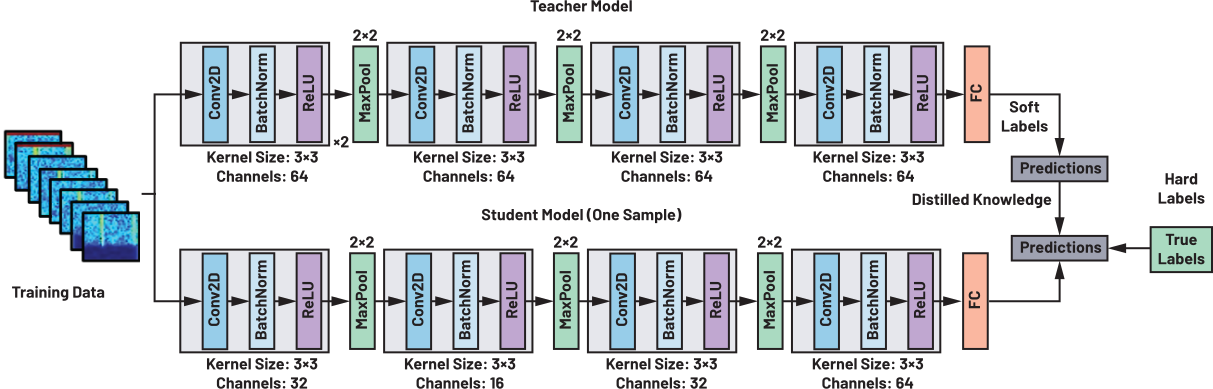
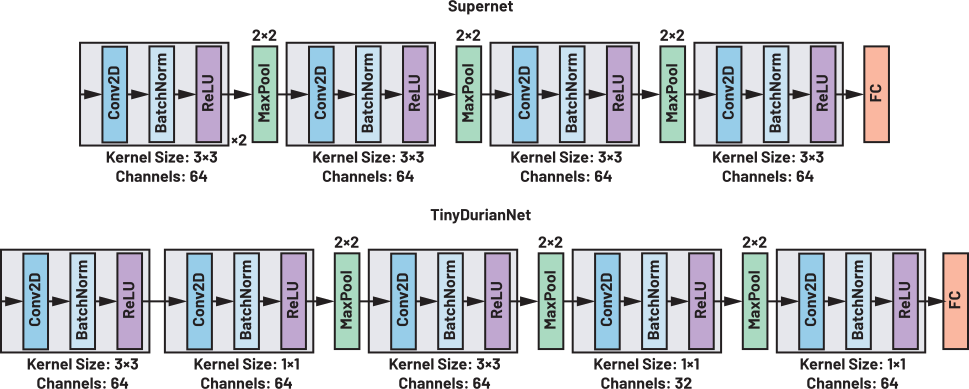
超網路是一種大型CNN網路,具有更深的層、更大的卷積核和更多的通道。其基於FP32,容易過擬合分類任務,但無法直接部署在MCU上。在此任務中,我們手動創建了一個序列化CNN超網路,如圖4所示。OFA超網路訓練核心為知識蒸餾(KD)和共用權重。請記住,OFA的目標是訓練一個超網路並自動獲得多個子網路,而非透過反覆運算獲得準確度最優的子網路,因為搜尋最優解決方案非常耗時。其要求搜尋過程中找到的任何子網路在準確度上不應有較大偏差。因此,訓練得到的超網路應盡可能穩健。KD是一種機器學習訓練技術,其讓學生模型(通常是小模型)的輸出性能與教師模型(通常是大模型)的輸出性能對齊。在原始OFA論文中,教師模型是目標超網路,而學生模型是從超網路取樣得到的架構子網路。子網路取樣透過超網路的彈性設計實現:形成較小的子網路時,可以縮減卷積核心尺寸、深度和寬度。在每次KD反覆運算中,學生模型再利用超網路的權重,其更新後的參數直接寫回至超網路。KD和共用權重相結合,共同確保各子網路的準確度和一致性。
網路架構搜尋(NAS)
完成穩健超網路訓練後,透過NAS自動搜尋小型子網路,我們稱之為TinyDurianNet。OFA採用進化搜尋策略來反覆運算子網路架構。相較於基於強化學習(RL)的NAS、DARTS2等傳統NAS搜尋方案,OFA使用的進化搜尋GPU資源佔用更少,時間成本也更低,因而搜尋過程非常高效。NAS過程會輸出多個準確度相似、架構不同的候選子網路。因此可以根據目標硬體的性能特徵和功耗限制,選擇一個合適的子網路作為最終的TinyDurianNet。例如,如果是準確度優先,那麼可以選擇參數更多的子網路;而對於資源受限或低功耗設備,則參數更少的更小子網路可能更合適。圖5展示了從NAS過程所獲得基於FP32的TinyDurianNet。
量化感知訓練(QAT)
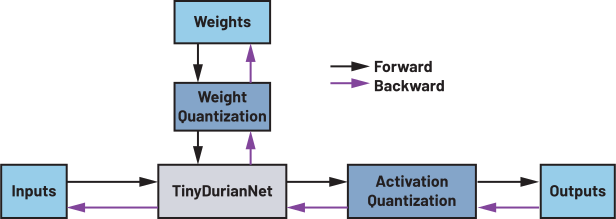
在原始OFA論文中,NAS找到子模型(基於FP32)後,子模型無需額外訓練即可部署。然而,MAX78002 CNN加速器僅支援INT1、INT2、INT4和INT8權重,因此需要QAT來使TinyDurianNet相容於MAX78002。QAT的核心原理是,在訓練過程中模擬低比特量化誤差(偽量化),讓模型學會在前向和反向傳播中自我調整量化雜訊,進而確保在低精度硬體上部署時保持準確度不變。ai8x的QAT在反向傳播中採用直通估計器(STE)規則。圖6展示了量化感知訓練流程。QAT完成後,即可獲得基於INT8的TinyDurianNet,它能直接部署在MAX78002上。
結果:AutoML訓練與性能表現
本次AutoML完整訓練使用一塊NVIDIA GeForce RTX 4090 GPU完成。表1匯總了OFA訓練配置及對應耗時。
| 任務 | 學習率 | 輪次/反覆運算次數 | 時間成本 |
| KD-Stage0 (完整模型訓練) | 0.001 | 200 | 1小時 |
| KD-Stage1(彈性卷積核) | 0.001 | 3000 | |
| KD-Stage2 (彈性深度) | 0.001 | 2500 | |
| KD-Stage3 (彈性寬度) | 0.001 | 9300 | |
| NAS | 50 | 10分鐘 | |
| QAT-subnet1 | 0.001 | 300 | 分鐘 |
| QAT-subnet2 | 0.001 | 300 | |
| QAT-subnet3 | 0.001 | 300 |
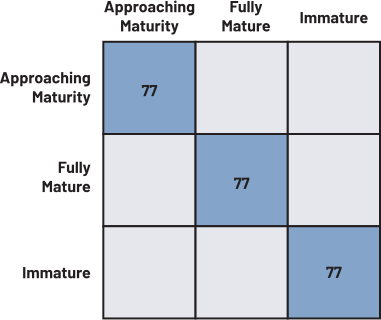
透過OFA流程訓練得到三個子網路,從中選擇一個作為TinyDurianNet。圖7顯示了TinyDurianNet在測試集上的推理準確度。
結果:實際系統測試
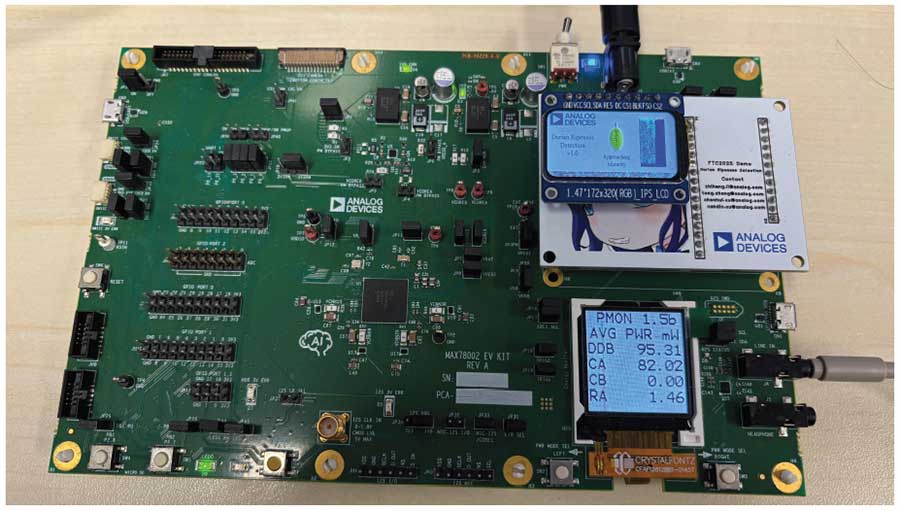
圖8展示了測試平台。我們預先錄製了一些榴槤敲擊振動訊號,轉換為音訊波形檔後在PC上播放。音訊訊號通過音訊線,以隨機時序輸入到MAX78002EVKIT。
測試結果如圖9所示。
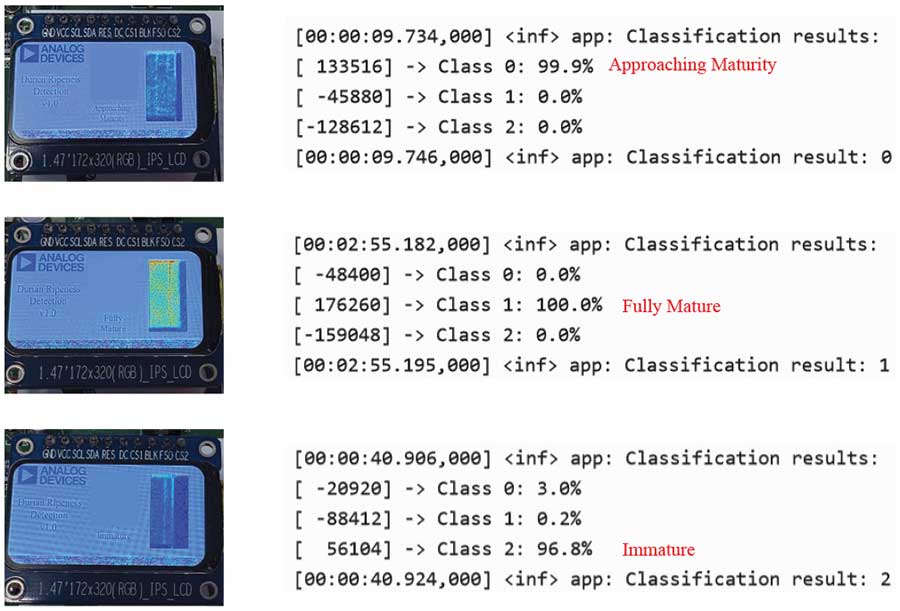
測試結果顯示,該系統能夠實現榴槤成熟度準確分類,展現出優異的穩健性。表2匯總了系統的推理速度和功耗指標。
| 指標 | 性能 |
| CNN推理時間 | 約3.06ms |
| 功耗 | 約180mW |
Zephyr OS如何優化AutoML落地部署流水線
藉由ai8x工具鏈,訓練好的模型可以匯出為運行於MAX78002的裸機工程,同時附帶與CNN加速器交互的參考示例代碼,協助客戶快速搭建推理流水線。然而,神經網路推理只是完整邊緣AI系統的一部分。如圖1所示,音訊流採用I2S+DMA(直接存取瀏覽)模式傳輸,分類結果還需在支援GUI的LCD上顯示。因此,實際應用系統還需開發週邊設備控制、資料流程控制和LCD人機交互介面(此解決方案採用羽量級通用嵌入式UI生態系統(LVGL))。隨著子系統數量與併發需求不斷增加,裸機架構的複雜度與維護成本大幅上升,開發者需要手動移植和修改大量驅動程式與中介軟體。為此,本解決方案運行於Zephyr OS 4.1上,該作業系統提供了基於裝置樹的硬體抽象、統一的驅動模型、多執行緒與同步機制、DMA支援的週邊子系統,以及模組化編譯和套件架構。
藉由這些功能,開發者可在MAX78002上快速整合I²S採集、STFT特徵擷取、CNN推理和LCD交互功能,大幅減少系統整合工作量,加速從演算法到可部署邊緣AI產品的轉化落地。
結論
本文重點介紹了MAX78002如何與AutoML和Zephyr OS結合,進而實現完整高效的邊緣AI工作流:從原始訊號採集,到部署完成的TinyML推理。該解決方案兼具即時性能和低功耗特性,同時可大幅降低模型設計工作量,因此可為客戶將機器學習整合至感測器類的應用提供一條實際可行的路徑。
同樣的架構可快速相容於其他基於「SP + 機器學習流程」的任務,進而充分體現ADI邊緣AI平台在加速開發、實現穩健量產級邊緣智慧方面的通用性。
參考文獻
11Han Cai, Chuang Gan, Tianzhe Wang, Zhekai Zhang, Song Han.“Once-for-All: Train One Network and Specialize it for Efficient Deployment”。2020年4月。
2Hanxiao Liu, Karen Simonyan, Yiming Yang.“DARTS: Differentiable Architecture Search”。2019年4月。